Natural Language Processing with Deep Learning CS224N/Ling284
http://web.stanford.edu/class/cs224n/slides/cs224n-2023-lecture11-prompting-rlhf.pdf
Since prompting, instruction tuning, RLHF, ChatGPT etc are such new and fast-moving topics, I haven’t seen many university course lectures covering this content.
So we made some new slides for this year’s CS224n: NLP w/ Deep Learning course at @Stanford!
X@jayelmnop
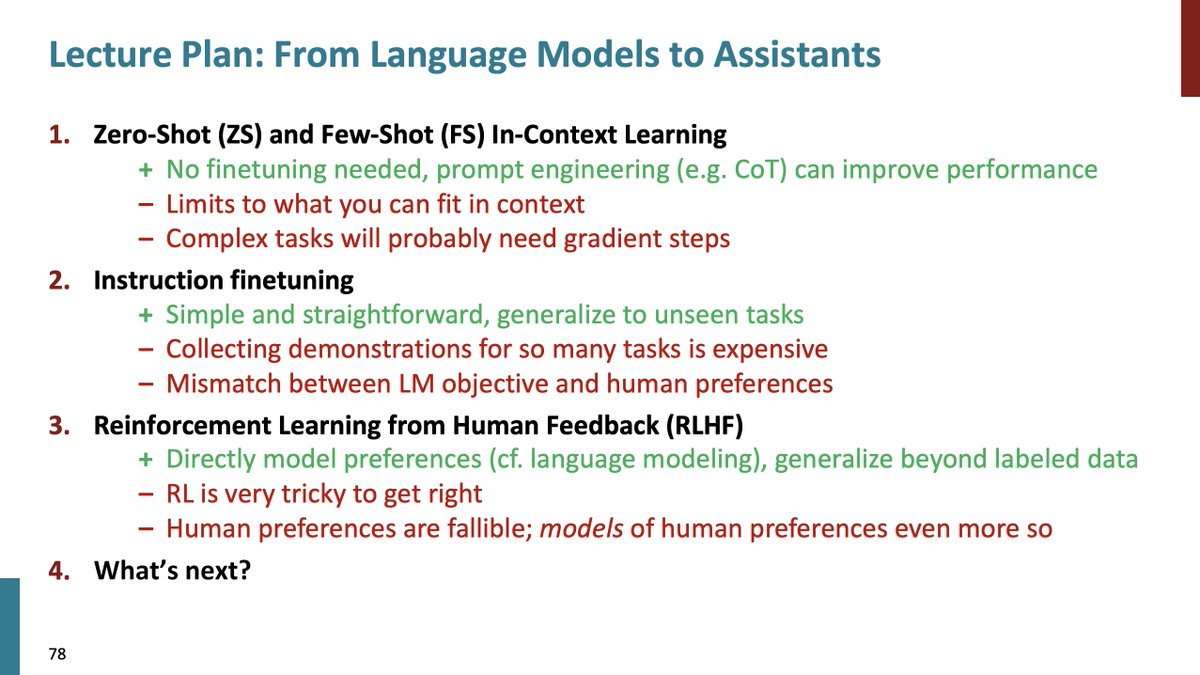
言語モデルからアシスタントへ
- Zero-Shot (ZS) および Few-Shot (FS) の
in-context learning - fine-tuning 不要で、
CoT などのprompt engineering に より 精度向上が できる - 制限が
ある (たくさん 例示は 厳しい) - 複雑な
タスクは まだ 出来ない (従来の fine-tuning に よる 勾配更新が 必要)
- 制限が
- fine-tuning 不要で、
- instruction finetuning
- 事前学習済みのLMに
対し、 多くの タスクに 渡る 命令と 出力の ペアを 集め、 fine-tuning する -
-
- シンプルで
分かりやすく、 未知の タスクへの 汎化が できる - 多くの
タスクの 例を 集めるのは コスト面で 高価 - LMと
人間の 目的が 厳密に 異なる とき、 人間の 趣向を 明示的に 満たせない
- 事前学習済みのLMに
- Reinforcement Learning from Human Feedback (RLHF)
- 事前学習 + fine-tuning より
高い 効果 -
- InstructGPT : RLHF を
30k の タスクに 拡張する - 人間の
趣向は 信頼できるか 怪しい - Reward modeling の
限界 -
- Chatbot だと
権威性が あり役立ちそうな レスポンスを 生成する 方向に 最適化される - それが
真実か どうかは 関係ない - → ハルシネーション へ
つながる
- それが
- Reward modeling の
- 事前学習 + fine-tuning より
- What’s Next?
- RLHF は
まだ データコストが 掛かる - [Constitutional AI]
の 登場 -
- [Constitutional AI]
- RLHF は
GPT (2018)
- 117M パラメータ
- 12層の
Transformer デコーダ - 4.6GB の
テキスト BooksCorpus
GPT-2 (2019)
- 1.5B パラメータ
- 同じ
アーキテクチャ - 40GB の
テキスト WebText - Zero-Shot learning
- 例なしで
多くの タスクを 実行する 能力 - 正しい
シーケンス予測 (Q&A)や、 配列の 確率の 比較など
- 正しい
- GPT-2 は
タスクに 応じた 微調整を 行わない 言語 モデリングに おいてSoTA
- 例なしで
GPT-3 (2020)
- 175B パラメータ
- 600GB 以上の
データ - Few-Shot learning
- = in-context learning
- タスクの
例を 前置して タスクを 指定 -
-
- これまでの
fine-tuning は 勾配の 更新が 伴うが、 prompting に よる 擬似的な fine-tuning が 勾配の 更新なしで できるようになった -
- ただし、
タスクに よっては 難しい -
-
- Chain-of-Thought prompting
-
- Zero-Shot の
CoT prompting